在游戏开发和人工智能领域中,深度强化学习(DQN)是一种结合了深度学习和强化学习(Q-Learning)的算法,能够处理复杂的环境和动态变化,本文将详细介绍DQN的基本概念、优势、实现步骤以及实际应用案例,帮助读者全面掌握DQN的核心思想。
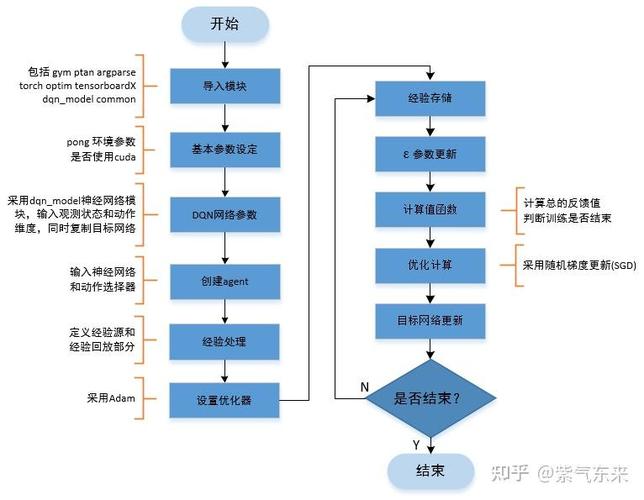
(图片来源网络,侵删)
DQN的基本概念
深度强化学习(DQN)是一种将深度学习应用于强化学习的算法,与传统的Q-Learning相比,DQN通过引入深度神经网络来处理高维状态空间,能够更好地捕捉环境中的模式和关系,DQN基于Q-Learning的框架,通过经验回放和奖励信号来优化状态价值函数,从而实现智能体的自主学习。
DQN的主要特点包括:
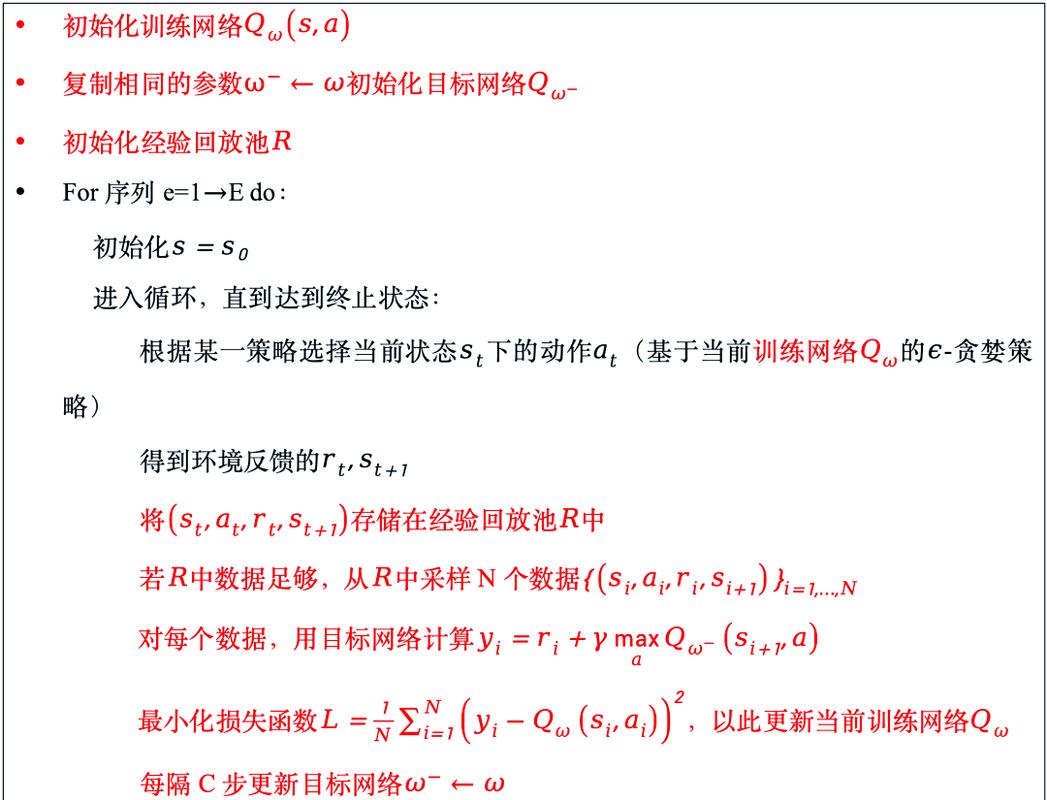
(图片来源网络,侵删)
- 状态价值函数:通过引入深度神经网络,DQN能够学习和优化状态价值函数,从而实现智能体的自主决策。
- 奖励信号:DQN能够通过强化学习机制,根据环境的奖励信号来调整状态价值函数的估计值。
- 稳定性:DQN的训练过程更加稳定,能够避免传统Q-Learning中的震荡和发散问题。
DQN的优势
- 处理复杂环境:DQN能够处理复杂的环境,尤其是高维状态空间,而传统Q-Learning难以应对。
- 适应动态变化:DQN能够适应环境的变化和挑战,如环境动态变化、噪声干扰等。
- 处理高维状态空间:DQN通过引入深度神经网络,能够有效处理高维状态空间,如游戏中的状态空间。
实现步骤
- 数据集的准备:首先需要一个高质量的强化学习数据集,数据集应该包含环境的多个状态、动作和奖励反馈。
- 模型的构建:选择合适的神经网络结构,通常包括输入层、隐藏层和输出层,输出层的大小取决于状态空间的维度。
- 训练过程的监控:在训练过程中,需要监控Q价值函数的更新过程,确保模型能够准确地学习和优化状态价值函数。
- 状态价值函数的更新:通过经验回放和奖励信号,更新Q价值函数,使得模型能够更好地预测状态的未来奖励。
- 模型的优化:根据训练过程中的表现,优化模型的参数,提升模型的预测能力和决策能力。
应用案例
- 游戏AI的训练:在DQN中训练一个AI,使其能够轻松击败DQN游戏中的对手,使用DQN训练一个AI在DQN游戏中获得高分。
- 环境控制:DQN可以用于控制复杂的环境,例如在工业控制、机器人控制等领域,DQN能够自动学习和优化控制策略。
- 预测和决策:DQN还可以用于预测和决策,例如在金融市场、医疗诊断等领域,DQN能够自动学习和优化决策策略。
推荐资源
通过本文的阅读,你可以全面掌握DQN的核心思想及其在实际应用中的潜力,无论是对开发者还是对研究人员,掌握DQN知识都能为自己的项目带来创新和突破。